HeyBlog 项目回忆录:个人版
发布时间:
大致记录一下我是怎么开始这个项目的,以及这个项目的开发历程,主要是我负责和熟悉的部分。
HeyBlog 项目介绍
这是一个通过友链智能发现博客并进行聚合的新时代博客聚合项目!
从一个博客出发,找到它的友链,并不断重复这个过程。如果所有博客组成一张连通图,那么理论上,我们可以找到所有博客,让每个博客都被看到。
可以访问以下网站进行体验:
- HeyBlog 早期版本:早期由我个人开发,现已不再维护和更新。你可以在上面看看自己的博客是否被找到,以及体验一个非常简陋的博客网络可视化功能。
- HeyBlog 当前版本:经过前后端重构的版本,目前有些功能还没完善。
起源
也许可以从我一系列与“人的联系”相关的想法,按照时间顺序说起。
大二的我在找实习,看了很多经验贴,然后发现其实很难找到和自己相似的经验贴。于是当时萌生出一个想法:建一个平台,每个人都以时间线记录自己的经历(例如学了什么、看了什么、做了什么项目等),同时也允许每个人更新自己的个人属性(例如学历、实习背景等)。这样一来,所有找工作的人只要在这个平台更新自己的经历,系统就可以用算法找到和你相似度最高的人,你也可以看看这个人最后去做了什么。但是这个想法太宏大,技术难度也太高,最后不了了之。
大四毕设的主题是“社区发现”。简而言之,就是仅通过每个节点之间的联系,将一堆节点划分成不同的社区。我觉得很有意思,进而也了解了社区计算之类的概念,虽然到最后,无论是毕设还是社会计算,都只是浅尝辄止。
大四毕业后的暑假,当时特别想做一个项目,也想找人一起做。理论上,我一个计算机专业学生,也有很多学计算机的朋友,但是我就是想不到找谁一起做:要么觉得对方对这个不感兴趣,要么觉得对方不适合合作,要么觉得对方的技术栈与项目不相关。因此又萌生出一个想法:其实大家对自己的社交圈并不了解。理想中应该有一个系统,我输入“我想找人合作开发一个某某项目”,系统自动在我的朋友和朋友的朋友中进行检索,然后给我推荐一份名单:这个人大概率也对该项目感兴趣,可以来做后端;这个人大概率对这个项目感兴趣,可以找他聊一聊。
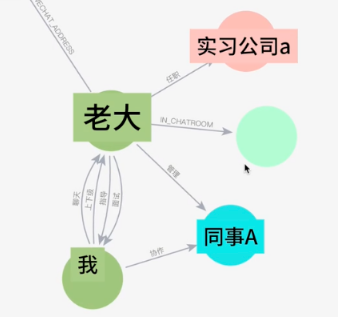
于是,与这些想法相关的代码第一次诞生了,也就是 DoYouReallyKnowYourSocialCircle 项目。这个项目的详细介绍见 B 站视频。简单来说,它通过我自己在社交软件中与他人的私聊数据以及群聊数据搭建社交关系图,其中节点是个人 ID、群聊 ID,以及 LLM 分析聊天记录过程中自动生成的实体节点(例如公司);边代表“个人—个人”“个人—群聊”,并通过 LLM 自动分析聊天记录来生成边的属性,例如“朋友”“恋人”等。
当时我使用了一些 GitHub 开源工具来解密这个社交软件存储在本地的数据,也就是我的聊天数据。后来实在不知道该如何将这个软件从个人使用扩展到多人,也担心一些法律风险,项目就不了了之了。值得一提的是,在这个项目之后几个月,我看到一则有关上述“用于解密的 GitHub 开源工具”的新闻,说项目已被相关公司法务警告,删库跑路了。非常遗憾听到这样的消息,并由衷地感到恶心。
之后读硕去了。有段时间压力很大,灵感也就随着压力一起诞生了:世界上有没有那么一个公开的“软件”,存储了大家的社交关系呢?有的,博客以及友链。以博客为节点、友链为边,它们天然形成了一张互联网社交关系图。
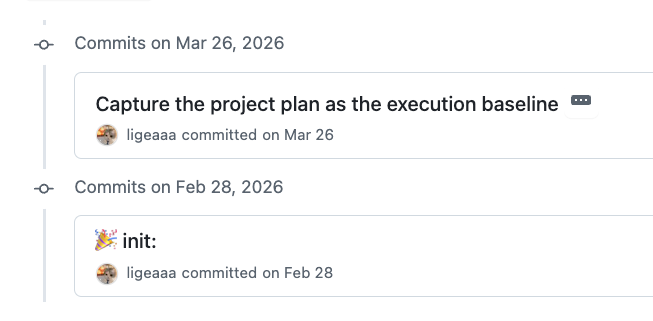
于是,项目于 2026 年 2 月 28 日在 GitHub 初始化,3 月 26 日完成第一次提交,4 月 18 日部署了早期版本。后面又经历了一些迭代,更新了一些小版本,甚至找朋友画了这个项目的虚拟形象。它算是我人生中第一次比较完整地做了一个项目。因为一直不喜欢前端,也不想学前端,所以在 AI 发展起来之前,无数想法都终止于没有前端 XD。
HeyBlog:个人开发时期
抱着深入体验 vibe coding 的觉悟,基本上整个项目没有手写过代码,就这样用 AI 糊出了前端、后端和爬虫。
- 我深刻体验到了当时的 GPT-5.4 在前端方面是何等薄弱:做出来的界面千篇一律,全是黄棕色、渐变和神秘框框堆叠。因此,我还花了一些时间折腾前端 skill,让它模仿 GitHub 的风格重构前端,调了很久才得到一版看得下去的界面。(写这篇博客的时候 GPT-6 出来啦!)
- 不考虑性能和安全的话,后端对于 AI 来说确实手拿把掐。我基本没在这上面花多少时间和精力,跑通就行。
- 爬虫则是我根据经验设计了一些爬取友链的规则,并添加了一些比较基础的规则来筛除无关结果。虽然最开始爬取出来的有许多无关链接,但考虑到目标是“跑通项目”,那也算是能用。
于是,基础架构搭完了,实现了爬取以及一些持久化功能,总的来说没花费太多时间。
最初的前端大概是这样:
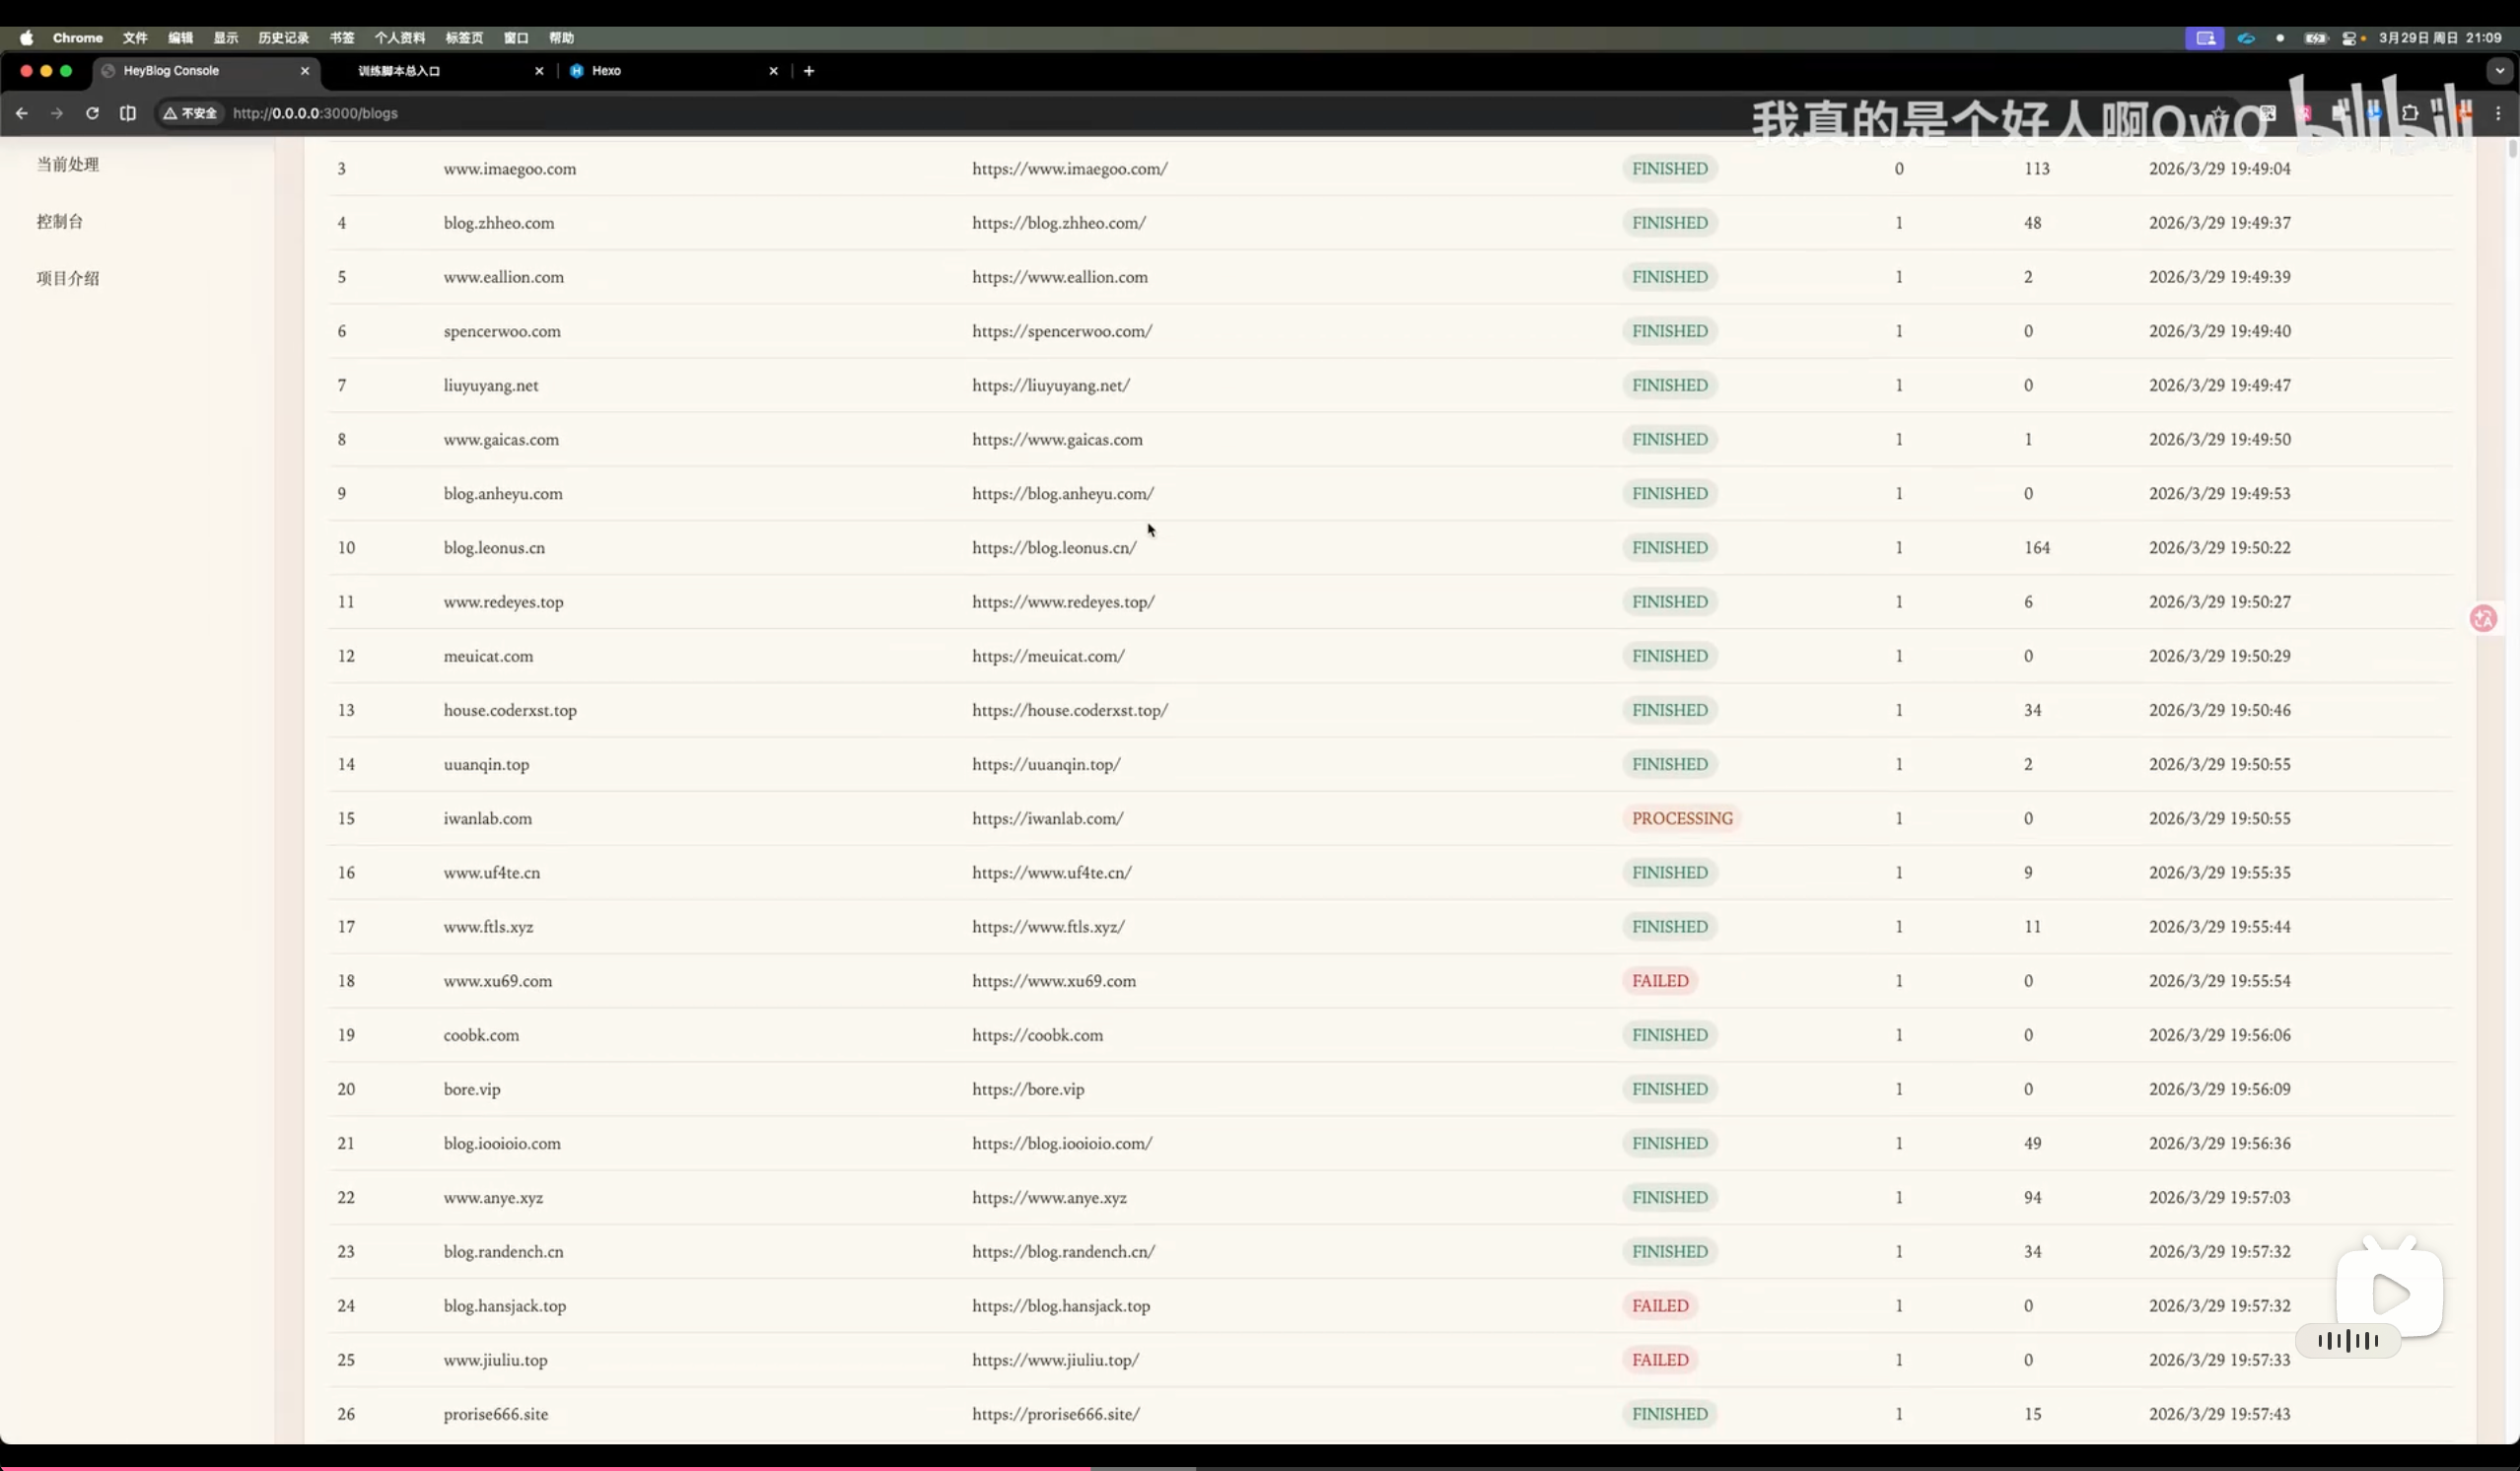
但这肯定是不够的,所以我开始慢慢增加功能。
当时优先级最高的是可视化关系图,依旧用 AI 做了一个,效果如下:
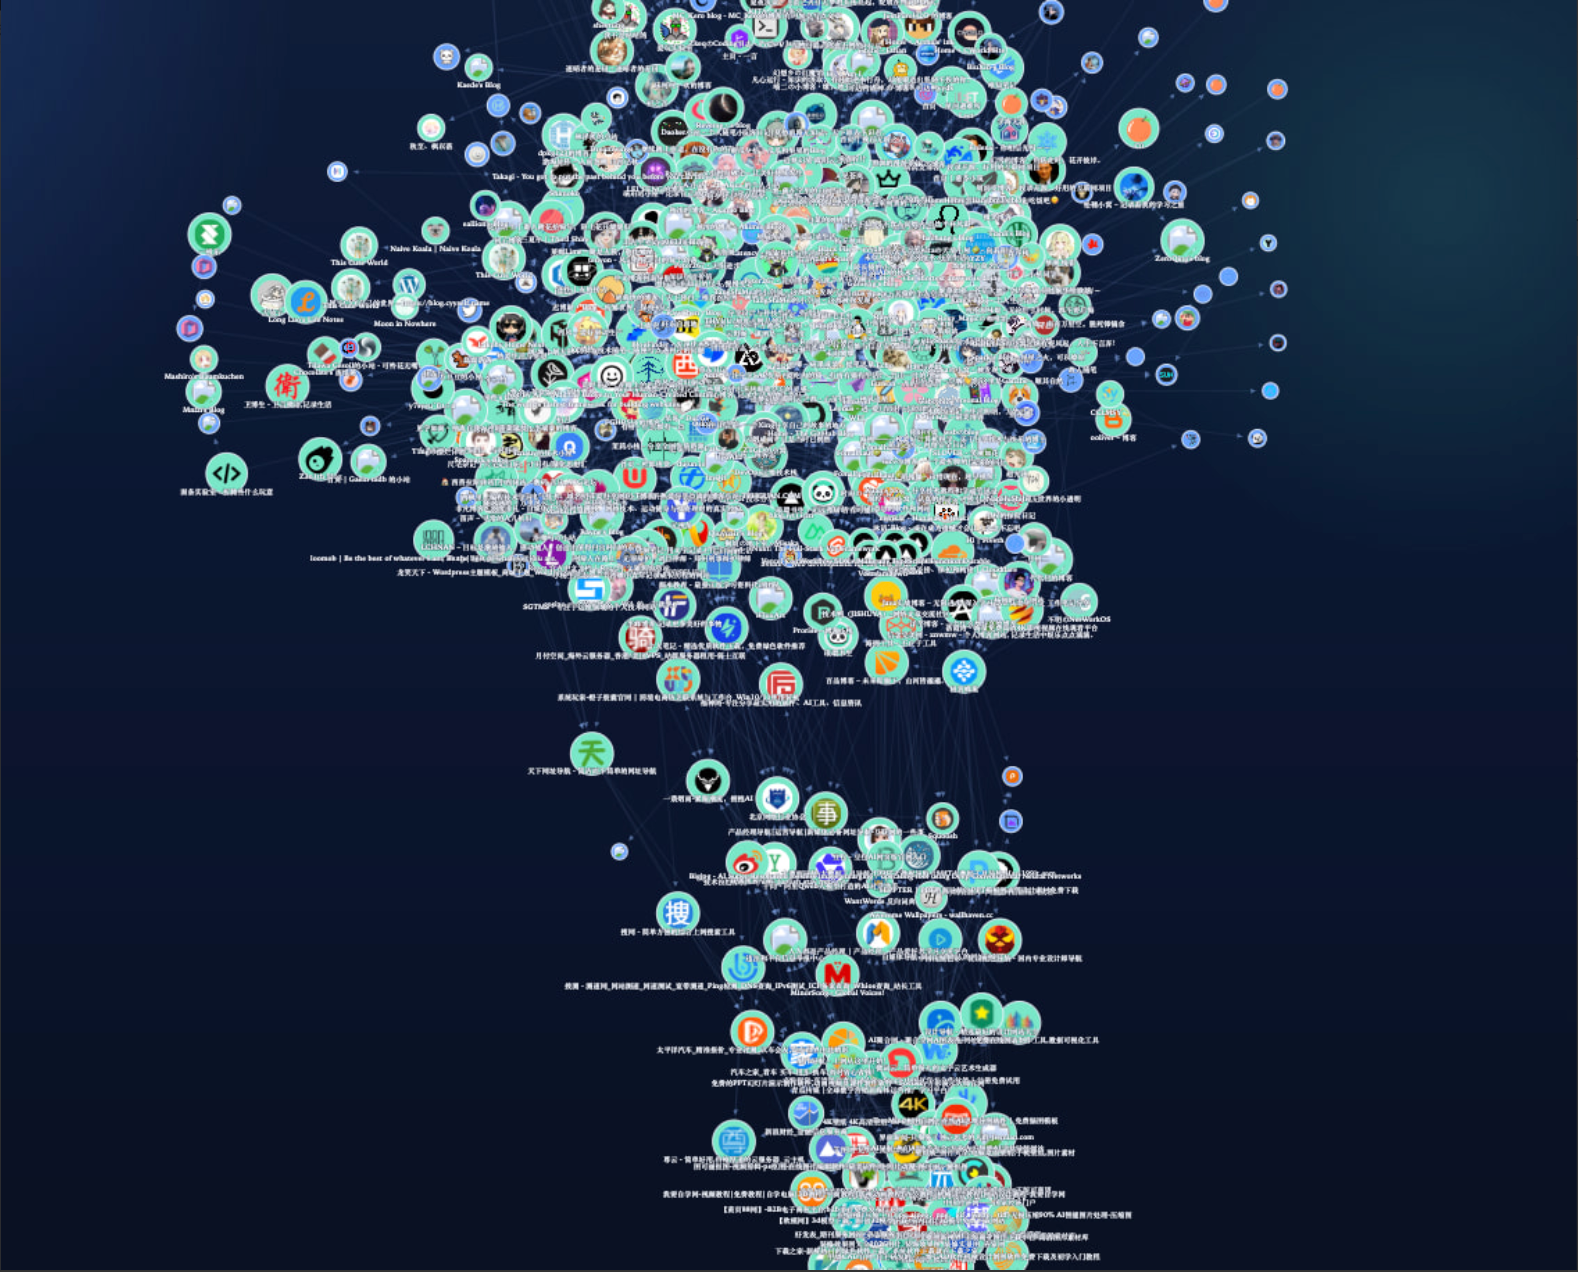
可以看到,因为当时只使用了简单的爬虫,也没做太多过滤逻辑,因此所有节点很明显地分成了两部分:上半部分的博客集群,以及下半部分的其他工具网站集群。
其实,因为我至今都没想清楚这个项目的实际意义,所以也无法很好地解释做这个可视化,以及之后所有功能的意义和目的。大概就是觉得这样很好玩,可以让人更好地理解和观察某些东西?
后来陆陆续续也更新了一些功能,但由于时间太久远,就不按时间顺序了,仅做简单描述:
- 更精致的博客关联可视化;
- 更详细的博客详情;
- 优化爬虫逻辑,在爬虫层面排除大量非博客 URL;
- 手工标注 3,000 条数据,用于训练分类模型,对爬虫获取的 URL 进一步分类。当然,因为数据太少,效果非常差;
- 新增随机博客功能,方便我一直刷。
HeyBlog 的一期部署在 heyblog.magic-knowledge.top。
HeyBlog 项目合并与重构
一期部署完成后,我想起来时就会去看几个随机博客。某一天,我看到一个名为 BlogsClub 的站点,是个博客聚合站。当时的爬取规则不够严谨,错误地将一些聚合站识别成了博客。我点进去后发现这是个比较新、比较活跃的聚合站点,并且留了一个 QQ 群,于是加群。加群后,我介绍了一下 HeyBlog 项目,并因此认识了 MYXXTS。他当时在维护集博栈(zhblogs),也是一个博客聚合网站,但是这个项目只剩他一个人在坚持。我们简单聊了一下对这类聚合网站未来的想法,发现非常合拍,于是决定将两个项目合并。他主要负责前后端,我主要负责算法部分。2026 年 6 月 14 日,两个项目正式合并,并保留了 HeyBlog 这个名称。我也可以开始专心做算法部分。
这个阶段,算法最核心的可能是两个部分:
- 博客二分类模型:输入 URL,输出该 URL 是博客的概率。该模型用于对爬虫获取的候选 URL 做进一步过滤筛选。
- 博客类别分类模型:输入 URL,输出该博客的类别。该模型用于对博客进行自动分类,例如生活博客、计算机博客、旅游博客等,以支持更好的搜索和推荐功能。
博客二分类模型
数据集
我将从数据来源和数据特征两个方面描述数据集。
数据主要有三种来源:
- 用户自己提供的数据。 经典的博客聚合网站由用户主动提交自己的博客信息,所以我们可以认为博客聚合网站中的网址都是博客。在此特别感谢开往、博友圈、blogFinder、BlogsClub、中文独立博客列表、ooh.directory等网站提供的这部分数据,最终总计 4,787 条正样本。
- 我本人标注的数据。 事实上,初始版本的 HeyBlog 已经有一定的自动寻找博客的功能。在一个简单的后台标注系统的帮助下,我边“刷”博客边标注该 URL 是博客还是其他网站,总计标注了 2,376 条,其中正样本(博客)651 条,负样本(非博客)1,725 条。
- 随机抓取的数据。 这部分数据参考了半监督学习中的弱标注思路。考虑到互联网上绝大多数 URL 都不是博客,可以将从通用网站数据集中随机抽取的 URL 近似标记为负样本。数据分别来自由内置中文站点清单、Tranco、hao123、2345 网址导航和 360 导航共同组成的中文站点聚合源,共 2,000 条;Common Crawl网页索引 2,000 条;Curlie网站目录 1,906 条;FineWeb-2 中文语料2,000 条;通过 Hugging Face Datasets Server抽取的网页语料 2,000 条;以及 Tranco 全球热门网站排行榜2,000 条。共抓取 11,906 条负样本。
上述数据经过合并、清理、去重和人工复核后,最终使用的数据集共包含 14,454 条记录,其中正样本(博客)5,367 条,负样本(非博客)9,087 条。
数据特征部分主要参考了 malicious-URL-detection,设计了一些结构化特征。同时,从一些推荐模型中获得启发,我使用 Qwen 文本嵌入模型对 URL 的标题和正文生成嵌入,并将生成的 token 同样作为特征传入模型。因为本文并不是技术文章,就不详细描述了!(实则写起来太累太复杂,偷个懒喵。)
评估指标
考虑到这是个二分类任务,主要使用 F1 和 PR-AUC 两个指标来评估模型。
模型架构
事实上,由于本任务的数据量并不大,模型训练也不会使用过多计算资源,因此直接让 AI 迭代模型架构似乎是个很好的选择。于是我给出了这样的任务:“我已经在当前目录下搭建好了评估流水线,请你不断迭代特征工程与模型架构,直至 F1 和 PR-AUC 均大于 0.95。”
事实证明,虽然这种可以快速迭代验证的任务似乎很适合 AI,但是在最开始将近 10 小时内,指标都没有显著提升,F1 和 AUROC 都维持在 0.8 左右,与作为基线的随机森林、SVM 没有显著差别。于是人工介入:“请仔细阅读某篇论文,并尝试模仿、应用其中的某个思路。”随后在接下来的 10 小时左右,指标飙升,F1 大于 0.9,PR-AUC 大于 0.95。又让它自主迭代了一会儿,最终得到 F1 = 0.9429、PR-AUC = 0.9858。虽然没有达到最初设想的指标,但也已经足够可观。考虑到暂时没有更多更好的思路,便停在了这里。我和 AI 真是太强啦 XD。(在后续的人工观察中,筛选出来的所有“博客”大概有 95% 是真的博客,可见还是有较大的提升空间。)
其他
顺带一提,用智能体判断一个 URL 是否为博客的思路一直存在于我的脑海中,因此我在训练模型的过程中也尝试了一下。没有做非常具体的记录,只是进行简单的 API 调用以及提示词设计,最终使用当时新出的 DeepSeek V4,在一个比较小的数据集上(我记得是 2,000 条左右?)花费 50 元,取得了 F1 大约为 0.85 的结果。也许继续迭代智能体系统可以让效果更好、更实惠,但因为初步结果实在不行,和简单的随机森林效果基本持平,便暂时搁置,作为最后的方案。实际上也没用上 XD。
顺便二提,写数据集部分有点写美了,感觉比写论文爽。
博客类别分类模型
虽然也有些网站,例如 ooh.directory,会提供博客标签信息,但是考虑到数据量较少、获取难度高、各个网站的标签规范并不一致,以及这种多分类任务对数据质量和数量的要求,从头训练一个模型似乎并不现实。
因此从实现角度考虑,也许从智能体出发,先搭建出一套标签系统,让标签正式上线,是比较合适的做法。
我们最终选择了三级标签设计。一级标签和二级标签互相强绑定,主要描述“领域—具体主题”。这两级标签由我们设计并提供,以较低频率迭代更新。三级标签则参考 Pixiv 等网站的设计,由用户自己提出,并与某个二级标签绑定,语义上是更加细微、具体的主题分支。
例如:计算机—网络安全—渗透。
一个博客的标签由它的 Feed 中的文章决定。我们会为每篇文章分配多个标签,最后将所有文章的标签汇总,取并集作为该博客的标签。
因此,我们主要搭建了三套智能体流程:
- 一、二级标签设计智能体工作流。 这个阶段没有任何明确的一、二级标签,只用于获取原始标签。访问数据库中所有博客的所有文章,将每篇文章截断后传入智能体,并要求它为文章提出一、二级标签。完成大约 1,000 个博客后,我们获得了大量原始的一、二级标签。
- 一、二级标签确定智能体工作流。 这个阶段根据原始的一、二级标签进行合并与人工审查,确认当前版本的标签体系。我们要求智能体从语义上合并所有标签,再进行人工审查和修改,最终得到 11 个一级标签、72 个二级标签。
- 一、二级标签分类智能体工作流。 这个阶段接收博客 URL,并返回该博客的一、二级标签信息。也就是根据该博客的文章信息,按照上述思路获取它的标签,同时要求每篇文章的标签必须在第二套智能体工作流设计出的一、二级标签中。
完成设计后,我们在某个中转站花费了大约 1,000 元,跑完了所有博客的标签分类任务。
叽里咕噜
以上,便是我目前在这个项目上的主要工作!
其中还有许多未提到的内容。例如,在设计博客二分类模型时,我想设计一套可以高自由度组合特征的系统。这个任务虽然只输入一个 URL,但是可以设计出非常多的特征,前前后后用过的特征超过一百种。哪个特征有用、哪个特征没用,或者哪些特征组合起来才有用,是一个理论上很难回答的问题,只能通过大量实验来验证。因此,我想设计一套系统,方便自由组合各种候选特征,根据选择的特征生成对应的不同版本数据集,然后运行同样的流程。但是这个系统比我想象中更困难,最后也没能提取出一个可用于其他任务的通用系统,只能在这个任务里将就用。甚至我现在回看,感觉也有点屎山。
嘛,无论如何,这算是我第一次从数据开始,从头完成一个模型的训练。感觉真不错。没有太多实际上的收获,但是很开心。
我希望有一天,我可以用一句话概括我想做的事情。也许到那一天,我会考虑读个博,也许是社会学,也许是计算机。总之,去读个博,把“这句话”用四年或者更长时间解决掉。
结尾
目前项目还在紧张刺激地高速开发迭代中!有许多有意思的功能将在不远的未来出现!
如果你感兴趣,欢迎通过以下方式联系:
- 微信:
qq132465798000 - QQ 群:
399523190 - 邮箱:lianggang2003@gmail.com
致谢
排名不分先后,感谢这些组织与个人: